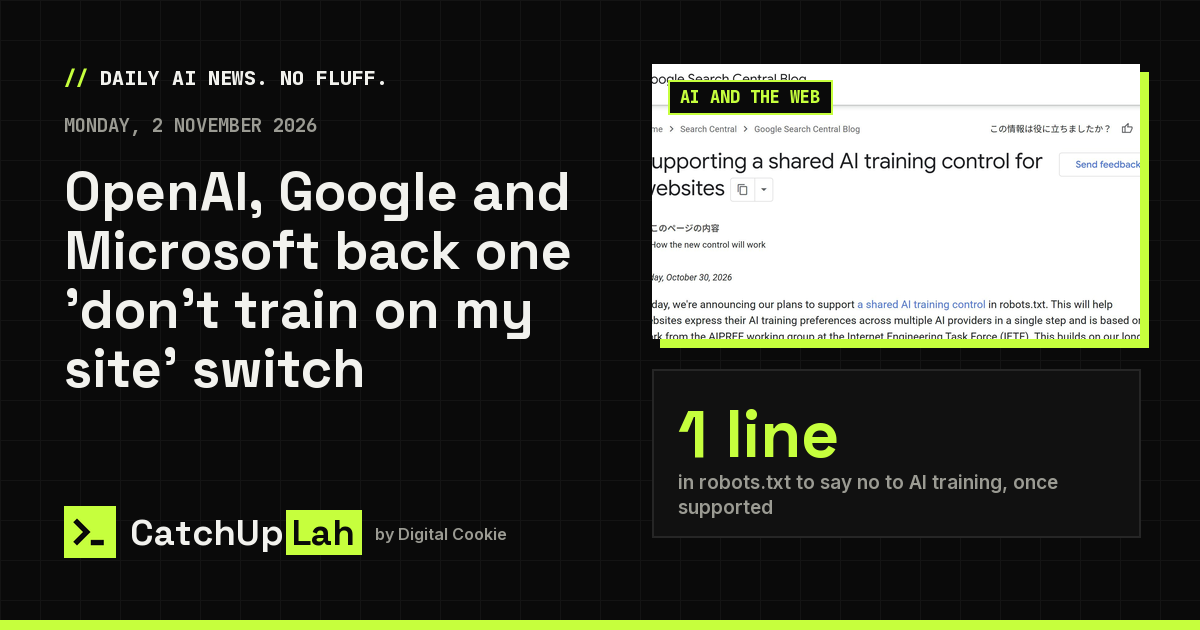

1 linein robots.txt to say no to AI training, once supported
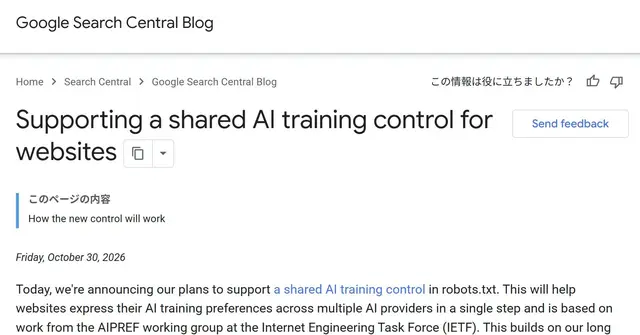
ウェブサイトが、大手AI各社すべてに「このページをAIの学習に使わないで」と伝える簡単な方法がもうすぐできるかもしれません。OpenAI、Google、Microsoftは10月30日に共通シグナルへの対応を表明し、Anthropicはすでに組み込みを進めています。
ポイント
- 仕組み:サイト運営者は、クローラーの行き先を決める既存のファイルrobots.txt A small text file on a website that tells automatic visitors, like search engine and AI crawlers, which pages they may or may not use.に短いルールを足します。User-Agent: __usage_ai-training の下にDisallowと書けば「学習に使わないで」、Allowなら学習してよいという意味です。サイト全体を拒否しつつプレスキットだけ許可する、といった組み合わせもできます(ITmedia、IThome)。
- 対象は学習だけです。クローラーの訪問や検索結果への表示は止めません。何も書かなければ、賛成でも反対でもない「意思表示なし」として扱われます。
- 時期は各社で違います。Anthropicが最初で、OpenAIは数カ月以内、Googleなどは2027年、Microsoftは2027年2月1日から読み取りを始めます。Googleは、サイトが別途指定しない限り、このシグナルの拒否を独自のGoogle-Extendedの拒否としても扱います。Metaは支持を表明しましたが計画は示していません。
- まだ提案段階です。もとはAnthropicのKevin Kelley氏が書いたIETFのInternet-Draft An early, public proposal for how something on the internet should work. Anyone can write one, and it has no official standing until a standards group approves it.で、正式な標準の地位はまだありません。Googleは、robots.txtを機械可読な拒否手段と認めるEU AI法の行動規範とも合うとしています。
なぜ重要か: 今はAI企業ごとに拒否の方法が違い、サイト運営者は一社ずつ対応する必要があります。共通スイッチができれば、各社が実行する限り、AI学習を断るのが1行で済みます。
情報源(2)
この記事は役に立ちましたか?
タップで投票。長押し・右クリック・Shift+Enterで、理由やひとことを添えて投票できます。