
1 linein robots.txt to say no to AI training, once supported
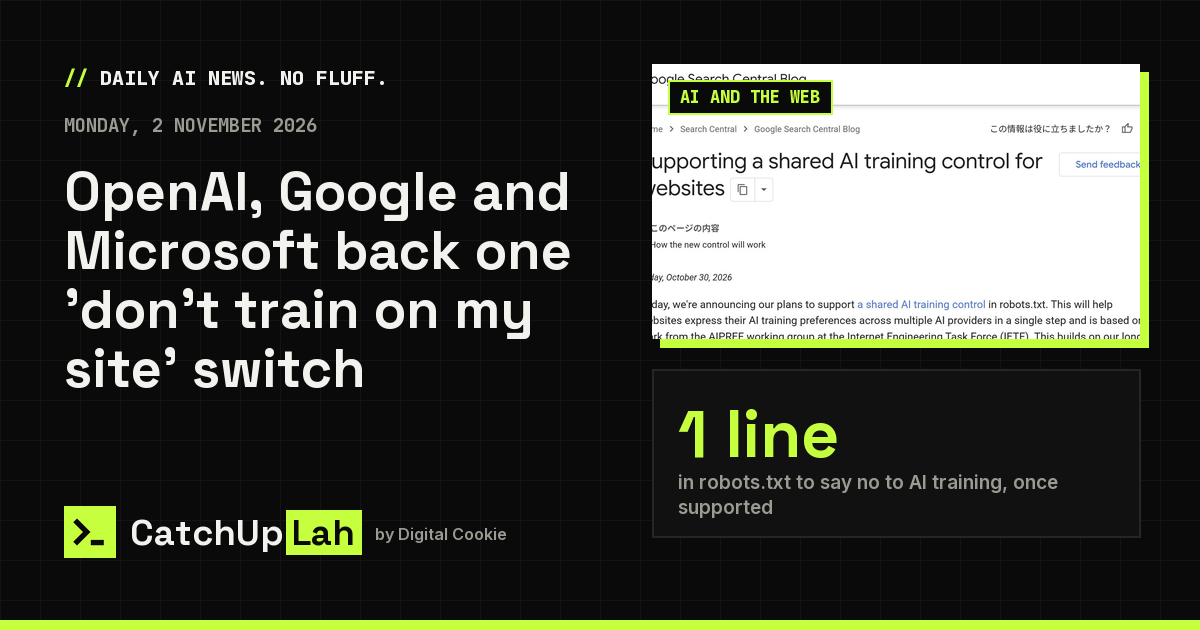
网站可能很快就能用一个简单的方法,告诉所有大型AI公司不要用自己的页面训练AI。OpenAI、谷歌和微软在10月30日表示将支持一个共同信号,Anthropic已经在接入。
要点
- 做法:网站主在robots.txt A small text file on a website that tells automatic visitors, like search engine and AI crawlers, which pages they may or may not use.(原本就用来告诉爬虫能去哪里的文件)里加一小段规则。在User-Agent: __usage_ai-training下面写Disallow表示“不要用来训练”,写Allow表示可以训练。也可以组合使用,比如整站拒绝、只开放新闻资料目录(ITmedia、IT之家)。
- 它只管训练,不会阻止爬虫访问,也不影响搜索结果展示。如果网站什么都不写,就算“没有表态”,既不是同意也不是拒绝。
- 各家时间不同。Anthropic最先支持,OpenAI目标是未来几个月,谷歌等公司目标是2027年,微软将从2027年2月1日开始读取该信号。除非网站另有说明,谷歌也会把这个拒绝信号当作对自家Google-Extended的拒绝。Meta表示支持,但没有给出计划。
- 目前仍是提案。它来自Anthropic的Kevin Kelley撰写的IETF互联网草案,还没有正式标准地位。谷歌表示,这也符合欧盟《人工智能法》行为准则,该准则把robots.txt视为机器可读的拒绝方式。
为何重要: 现在每家AI公司的拒绝方式都不一样,网站主得一家一家去设置。有了统一开关,只要各家落实,拒绝AI训练只需一行。
来源(2)
这篇报道有用吗?
轻点即可投票。长按、右键或按 Shift+Enter 可先添加理由或备注。